

Коротко: бронза из 6 299 команд
Я взял бронзовую медаль на Kaggle в соревновании RSNA Knee Abnormality Detection: 438-е место из 6 299 команд. Задача — научить нейросеть смотреть МРТ колена и находить 12 проблем: разрывы связок и менисков, артроз, жидкость в суставе, переломы и так далее.
Летом я писал гайд, как залететь в соревнование OpenAI по безопасности ИИ-агентов. Там медаль я не взял. Это второе соревнование в моей жизни на Kaggle — и первая медаль.
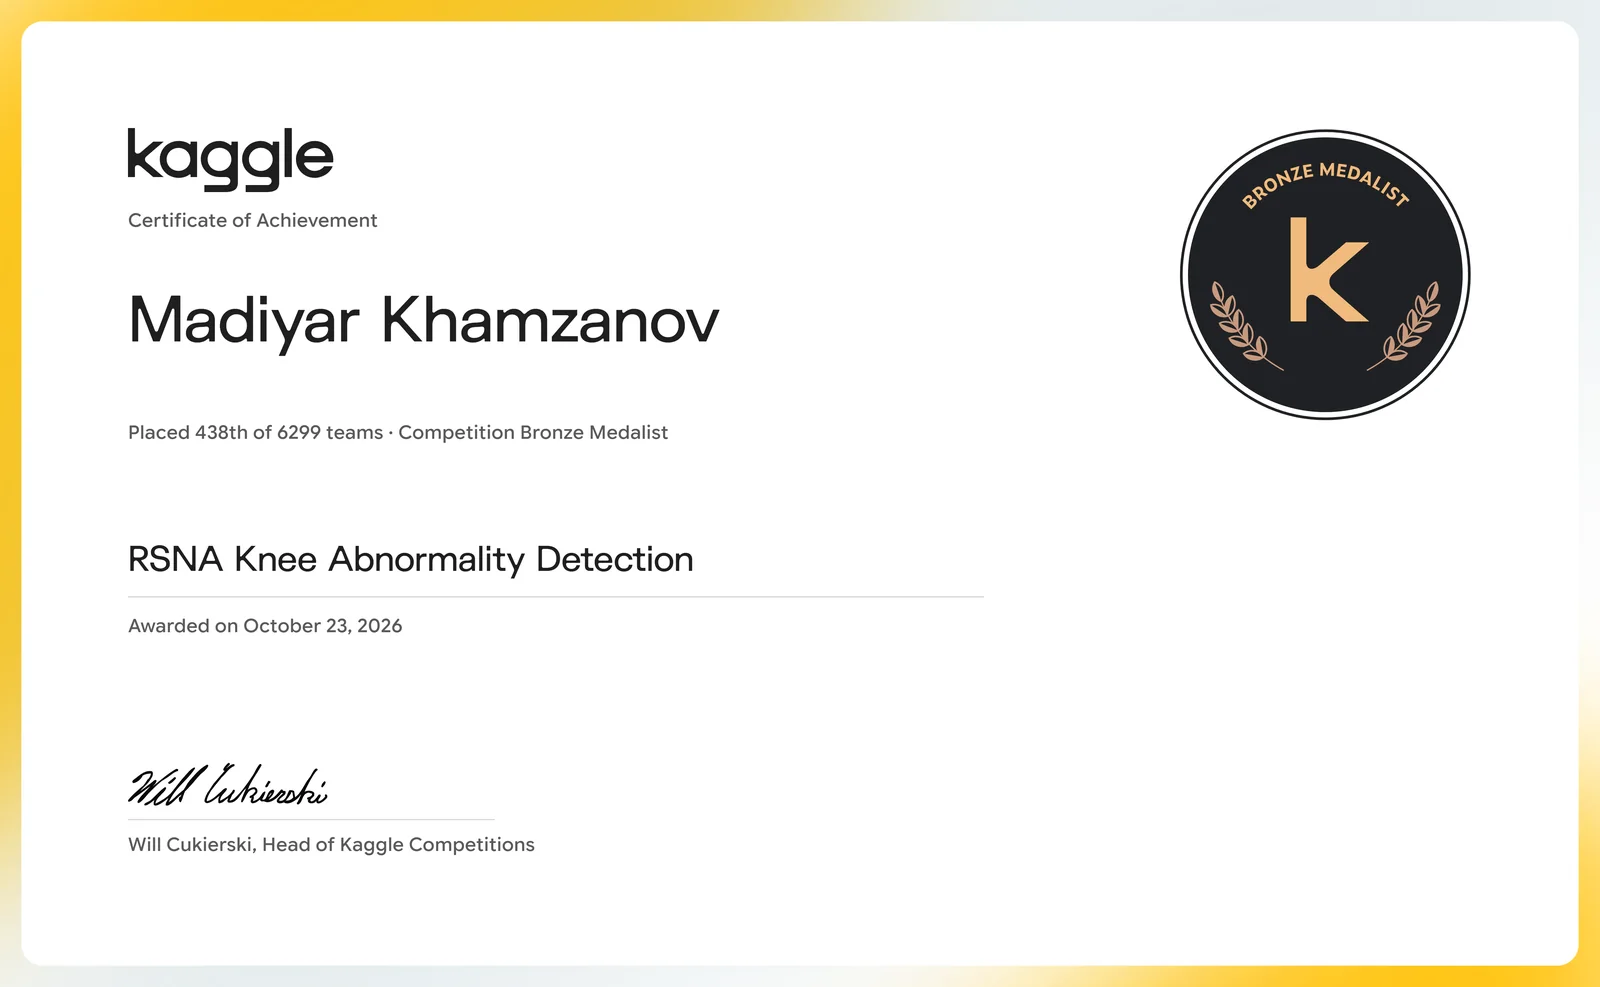
Ниже разбираю всё простыми словами: что такое МРТ для компьютера, как ставили оценки, как устроено моё решение и чем оно отличается от решений победителей. Картинки — из самого соревнования и из открытых разборов топовых команд.
Что за соревнование
Соревнование провели RSNA — Радиологическое общество Северной Америки и Kaggle. Шло оно с 30 июля по 22 октября 2026 года. По итоговому посту Kaggle, это самое массовое соревнование RSNA за всю историю:
Данные собрали 22 клиники из разных стран: Бельгия, Аргентина, Таиланд, Тайвань, Марокко, Чили, Турция, Канада, США, Германия, Греция, Монголия, Австралия и другие (описание данных). В обучающей выборке 4 407 МРТ-исследований колена. У каждого есть заключение радиолога — на разных языках, в зависимости от клиники. В тесте около 1 300 исследований, и заключений к ним уже нет: модель должна смотреть только на снимки.
Призовой фонд — $77 000. Из них $59 000 делят 10 лучших команд основного лидерборда, ещё $18 000 — трек эффективности, где оценивают и точность, и скорость. Решение сдаётся не файлом, а ноутбуком: Kaggle сам запускает твой код на скрытых данных, без интернета и максимум 9 часов на видеокарте.
Что искали: 12 проблем колена
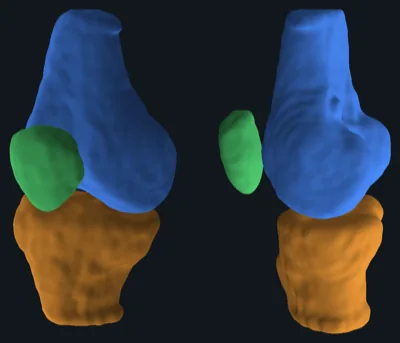
Колено — это три кости: бедренная сверху, большеберцовая снизу и надколенник (коленная чашечка) спереди. Между ними — хрящ и два мениска, амортизаторы в форме полумесяца. Держат всё связки: внутри сустава крестообразные, по бокам — коллатеральные.
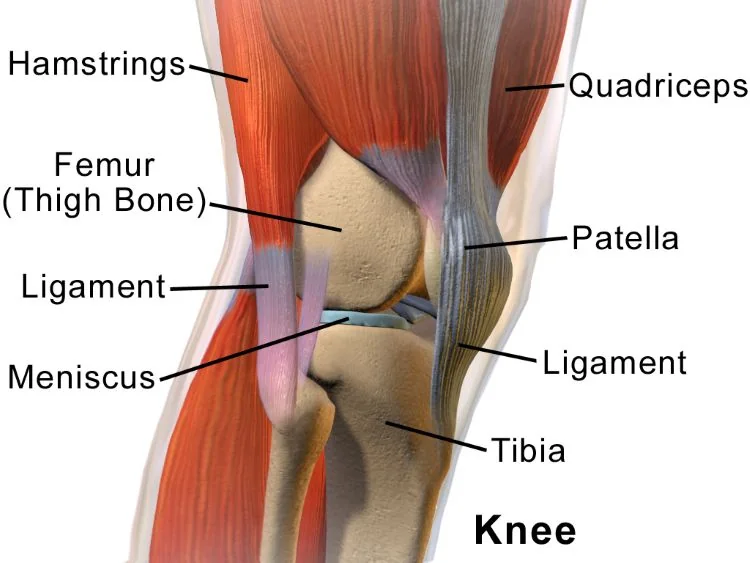
На каждое исследование нужно выдать 12 вероятностей: насколько модель уверена, что проблема есть. Важная деталь: размечали строго. Если радиологи сомневались, ставили «нет». Например, лёгкое растяжение связки — это «нет», считается только серьёзный разрыв.
| Метка | Что это простыми словами |
|---|---|
| ACL | Разрыв передней крестообразной связки — классическая травма футболистов и лыжников |
| MCL | Свежий серьёзный разрыв внутренней боковой связки |
| Medial Meniscus | Разрыв внутреннего мениска |
| Lateral Meniscus | Разрыв наружного мениска |
| Medial OA | Артроз внутренней половины сустава: хрящ стёрт больше чем наполовину |
| Lateral OA | То же для наружной половины |
| PF OA | Артроз между надколенником и бедром |
| Effusion | Много жидкости в суставе (выпот) |
| Synovitis | Воспаление внутренней оболочки сустава |
| Baker's | Киста Бейкера: мешок с жидкостью под коленом сзади |
| Contusion | Ушиб кости: отёк внутри кости без трещины |
| Fracture | Свежий перелом |

Как МРТ выглядит для компьютера
Обычный человек думает, что МРТ — это одна картинка. На самом деле одно исследование — это пачка «серий». Каждая серия — стопка тонких срезов колена, как нарезанный батон: обычно 20–45 срезов, в среднем 30. Режут в трёх плоскостях: сбоку (сагиттальная), спереди (корональная) и сверху вниз (аксиальная). В одном исследовании от 3 до 14 серий — то есть сотни картинок на одно колено.
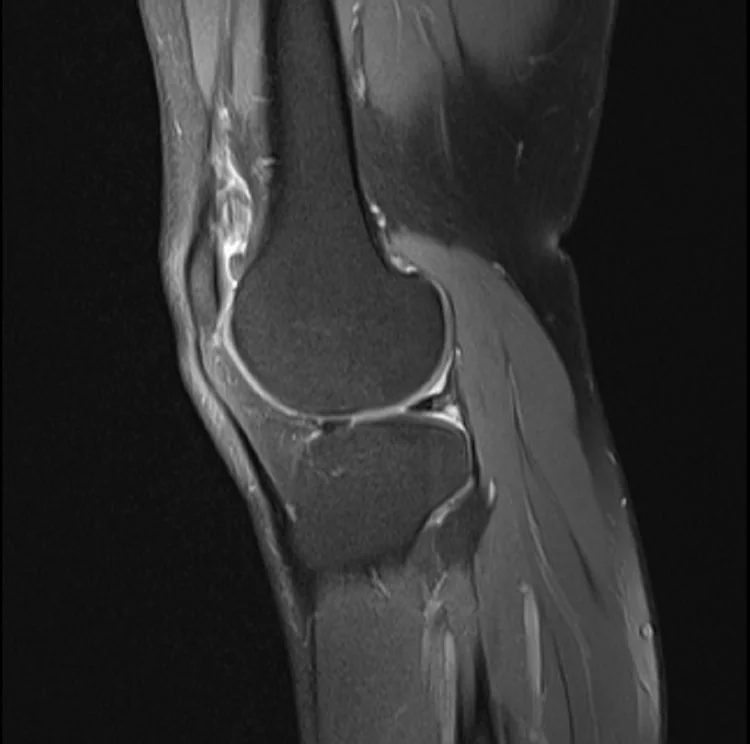
Серии ещё и снимают в разных режимах. В одних жидкость светится белым — на них видно отёк, выпот и разрывы. В других лучше видна анатомия. Радиолог листает все серии и в голове собирает 3D-картинку. Модели приходится делать то же самое.
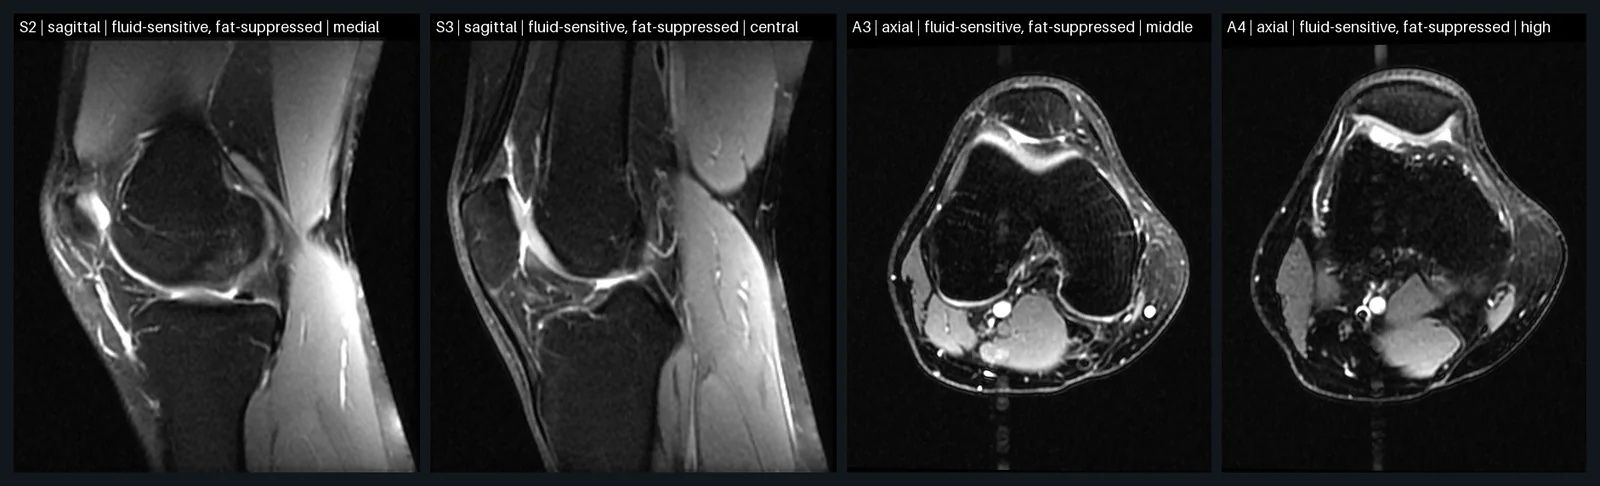
Технически всё это лежит в формате DICOM: один файл — один срез, плюс служебные поля (толщина среза, положение в пространстве). Разные клиники, разные аппараты, разная яркость и разрешение, часть файлов сжата в JPEG Lossless и JPEG 2000. Для нейросети это первый подводный камень: если не умеешь читать какой-то формат сжатия, часть срезов молча пропадает.
Попробуйте сами: норма или разрыв
Вот примеры из руководства, по которому радиологи размечали данные. Переключайте «Норма» и «Находка» и сравните. Обратите внимание: «норма» тут часто не идеально здоровое колено, а пограничный случай, который не дотягивает до критерия. Именно на таких случаях и ошибаются модели.
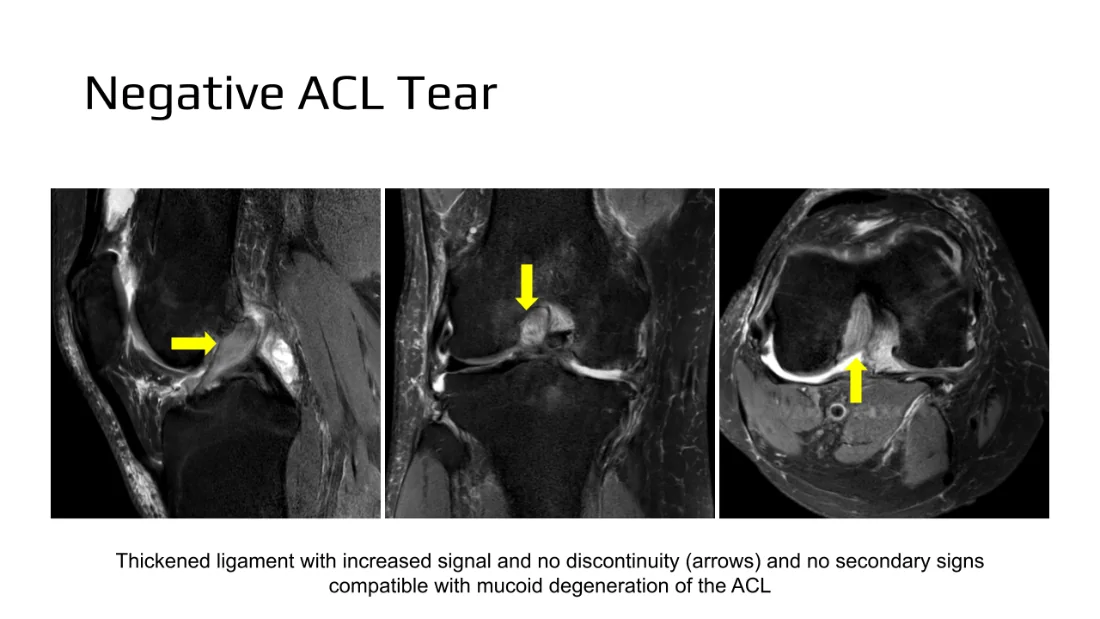
НормаНет разрыва: связка утолщена и светится, но цела. Это дегенерация, а не разрыв — метка «нет».
Снимки — из руководства для разметчиков соревнования (Dr. Jacob Kazam), опубликованы в официальном обзоре на Kaggle.
Как ставили оценки
Метрика — средний ROC AUC по 12 находкам. Звучит страшно, но суть простая. Возьмите случайного пациента с разрывом и случайного без. AUC — это вероятность, что модель поставит больному оценку выше, чем здоровому. 0,5 — подбрасывание монетки, 1,0 — идеально. AUC считают для каждой из 12 находок и усредняют.
Важное следствие: AUC не волнуют сами вероятности, только порядок. Если модель всем больным ставит 0,51, а всем здоровым 0,49, это идеальный AUC = 1,0. Это пригодится дальше, когда буду объяснять смешивание моделей.
Главная загвоздка: 58 ответов на 4 407
Вот что делает это соревнование необычным. Из 4 407 обучающих исследований правильные ответы (12 меток от радиологов) есть только у 58. У остальных 4 349 — только текст заключения: «ACL разорвана», «умеренный выпот», «мениск без особенностей». На восьми с лишним языках и в стиле конкретной клиники.
Значит, сначала надо самим превратить заключения в метки. Почти все сильные команды делали это большими языковыми моделями: GPT, Claude, Gemini, DeepSeek читали текст и выставляли 12 вероятностей. Ещё в начале соревнования участники выложили такие таблицы в открытый доступ (stevenleehans, pilkwang). А топы пошли дальше и дали моделям смотреть ещё и сами снимки.
Почему не хватает одного текста? Как заметили в 5-м месте: «не упомянуто» — это не «нет». В одной из публичных таблиц на 27% пар «исследование — находка» ответа не было вовсе, а для синовита — на 84%. К тому же врач пишет «небольшой выпот», а по правилам соревнования считается только умеренный или большой.
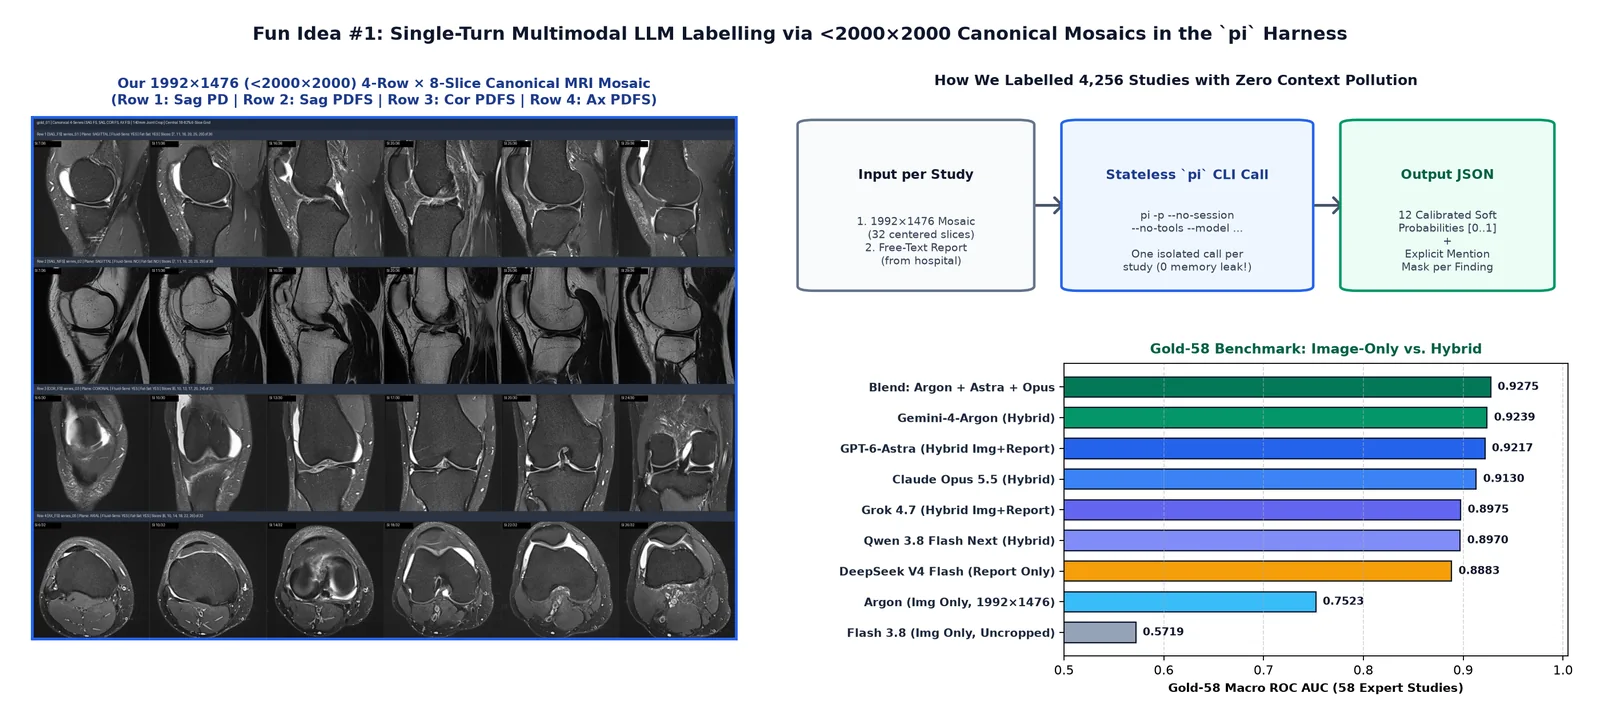
Насколько хорошо нейросети «ставят диагноз»
Средний AUC на 58 исследованиях с ответами радиологов. Модель видит мозаику из 32 срезов и текст заключения
Самое интересное на графике — правые столбики. Та же Gemini, которой показали только снимки без заключения, падает с 0,92 до 0,75. Читать текст языковые модели уже умеют отлично, а вот смотреть МРТ сами — пока заметно хуже. Поэтому лучший рецепт — текст плюс снимки, а потом ещё отдельная нейросеть, обученная именно на картинках.

Как устроено моё решение
Мой финальный ноутбук rsna-b1-ctrl — это конвейер из двух разных моделей, которые смотрят на колено по-разному, а в конце их ответы смешиваются.
Модель 1, Raptor. Внутри — CoAtNet: первые слои работают как классическая свёрточная сеть (ищут края, текстуры, пятна), дальше идёт трансформер — та же технология, что внутри ChatGPT, только для картинок. Хитрость в обучении по принципу multiple instance learning. У нас есть ответ на всё исследование («разрыв есть»), но не сказано, на каком из сотни срезов он виден. Модель сама учится находить срезы-подозреваемые. Веса усреднены по нескольким моментам обучения (SWA): как спросить одного врача утром, днём и вечером и взять среднее. При запуске модель смотрит и на снимок, и на его зеркальную копию.
Raptor обучали не только на данных соревнования, но и на открытом датасете Osteoarthritis Initiative от Национальных институтов здоровья США — тысячи МРТ коленей с артрозом. Метки для 4 349 исследований без ответов взяли из нескольких открытых таблиц, которые участники получили языковыми моделями.
Модель 2, R7. Четыре сети ConvNeXt, каждая обучена на своих трёх четвертях данных: коллектив из четырёх «врачей» вместо одного. Сначала находит центр сустава и вырезает квадрат вокруг него, чтобы мелкие разрывы не терялись на большом снимке. При обучении ей помогал открытый датасет fastMRI от NYU и Meta. Для выпота отдельно оценивается объём жидкости, для кисты Бейкера — свой маленький досчёт. R7 работает сразу на двух видеокартах.
| Компонент | Что это | Автор |
|---|---|---|
| Базовый ноутбук | Конвейер Raptor + R7 со смешиванием 50/50 | heliosli |
| Raptor: рецепт | CoAtNet + multiple instance learning | dreaddevelopment |
| Raptor: веса | Дообучение на всех данных + OAI, усреднение SWA | nartaa |
| R7 | 4 × ConvNeXt-small, кроп сустава, fastMRI, досчёты выпота и кисты | heliosli |
| Метки из заключений | Таблицы 12 вероятностей от языковых моделей | stevenleehans, pilkwang, riadmohamed42 |
| Декодеры JPEG | Офлайн-пакеты pylibjpeg / openjpeg | goodpjw2008 |
| Сборка и проверки | Декодеры во все этапы, остановка при любом сбое, финальные проверки | я |
Почему смешиваем места, а не вероятности. Помните, AUC важен только порядок? Raptor может быть уверен во всём на 0,9, а R7 осторожничать на 0,3 — если смешать вероятности, одна модель задавит другую. Поэтому каждая модель выстраивает пациентов в очередь от «точно есть» до «точно нет», и мы берём среднее место в очереди. Я специально не подбирал веса под публичный лидерборд — 50/50 и всё.
Где я среди 6 299 команд
Финал: 438-е место, скор 0,943 на приватной части. На публичной было 0,958 и 343-е место — после дедлайна я съехал на 95 позиций вниз. Посмотрите на распределение: огромный столб на 0,942.
Как распределились 6 299 команд
Сколько команд набрали каждый скор на приватной части теста
Это 1 297 команд с одинаковым до третьего знака скором. В основном это люди, которые отправили сильный публичный ноутбук почти как есть. Граница бронзы прошла ровно через эту стену: 629-е место — ещё 0,942 с медалью, 630-е — тоже 0,942, но уже без неё. Решали десятитысячные доли. По пятизначным оценкам из официального ноутбука Kaggle, я был выше границы бронзы примерно на 0,0003, а до серебра не хватило около 0,0005.
| Зона | Места | Скор |
|---|---|---|
| 1-е место — Team Kangaroo | 1 | 0,960 |
| Золото | 1–22 | 0,954 и выше |
| Серебро | 23–314 | 0,943–0,954 |
| Бронза | 315–629 | 0,942–0,943 |
| Я | 438 | 0,943 |
| Половина всех команд | до 3 150 | 0,925 и выше |
| Уровень монетки | 219 команд | 0,500 и ниже |
Отдельная история — тряска лидерборда. Команда Barry была №1 на публичной части с 0,970 и финишировала 7-й. Team Kangaroo шла 4-й и стала первой. Публичный лидерборд — это всего лишь часть теста, и подгонка под него наказывается. Поэтому я и не трогал веса смешивания.
Как решали победители
Самое ценное на Kaggle — разборы решений, которые топы публикуют после финала. Я прочитал разборы 1-го, 5-го, 7-го и 235-го мест. Общее у всех одно: они выиграли разметкой, а не хитрой архитектурой.
1-е место: соревнование по разметке
Team Kangaroo (tascj и liushuzhi) прямо пишут в своём разборе, что относились к задаче как к соревнованию по разметке. На каждое из 4 407 исследований запускали отдельного ИИ-агента в командной строке: Codex, Claude Code. Агенту давали папку со срезами в PNG, заключение и инструменты «приблизить срез» и «найти ту же точку на другой серии». Агент сначала выписывает улики из текста и из снимков, а уже потом ставит вероятность. В среднем одно исследование — 2,5 минуты и 15 просмотренных картинок.
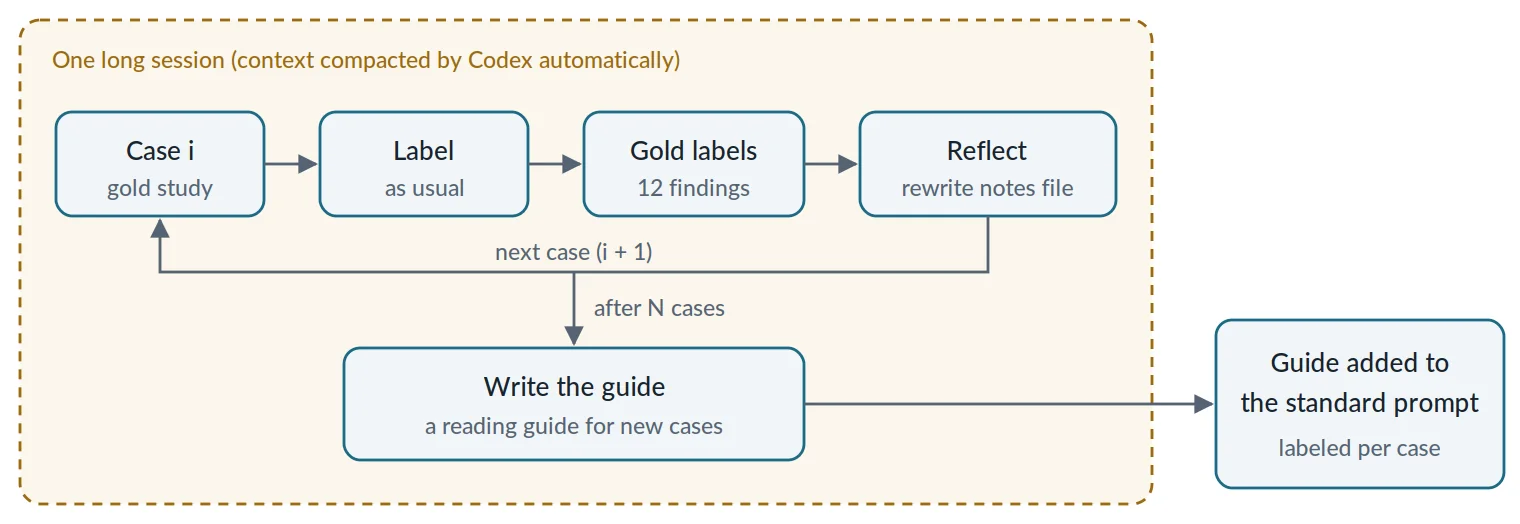
Качество такой разметки на 58 эталонных исследованиях росло от 0,904 до 0,943 AUC, в зависимости от модели и инструкции. Но этим не ограничились. Агенты ещё нарисовали рамки: где на каждой серии лежит нужная анатомия (751 исследование) и где именно видна проблема — 1 800 исследований, 3 616 поражений, 111 029 рамок. Вручную это месяцы работы радиолога.
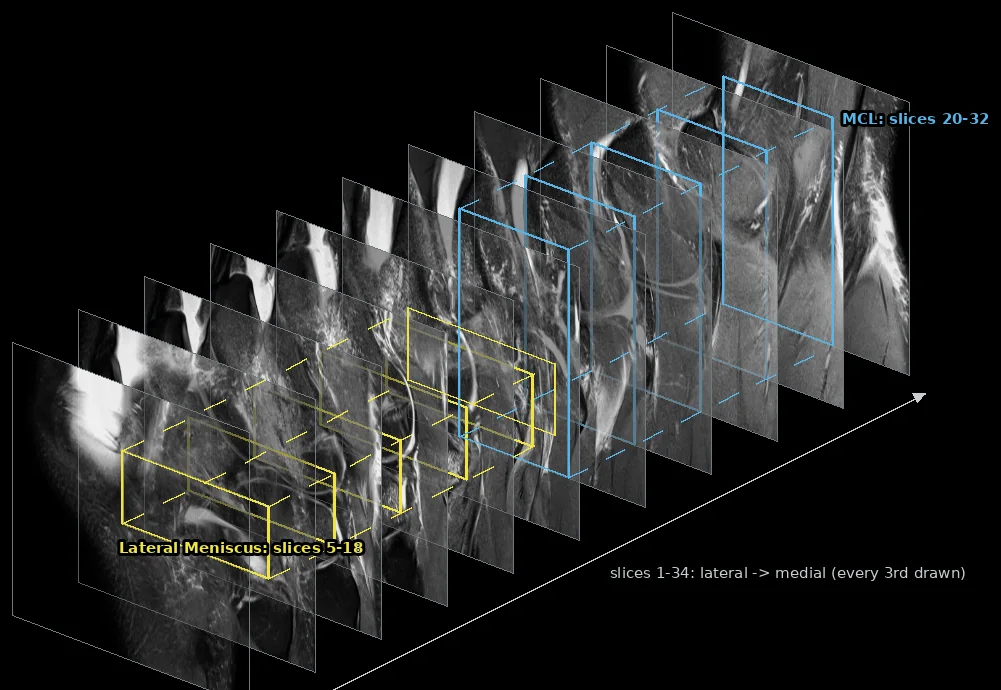
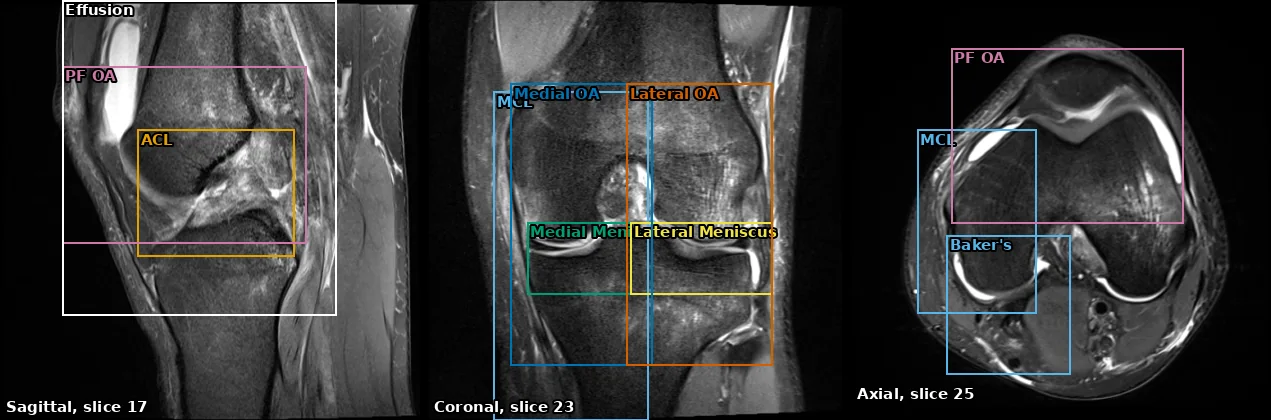
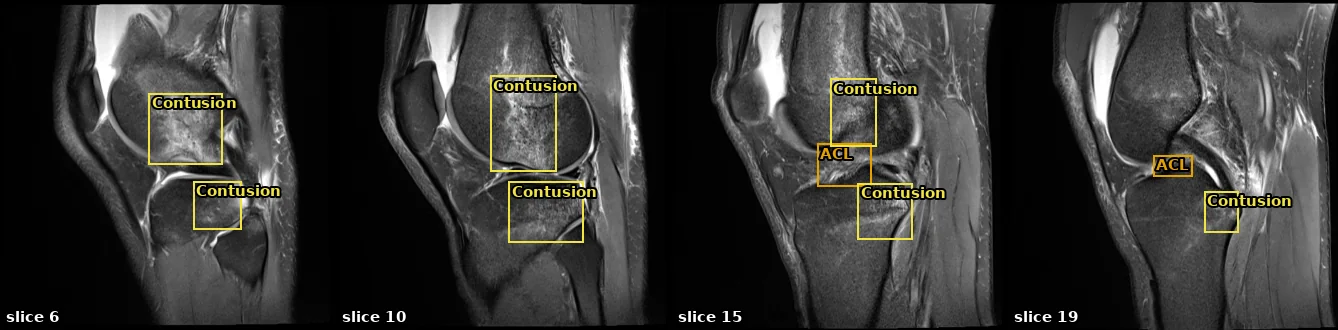
Дальше простая и красивая модель. Отдельный детектор на тесте находит рамки для каждой из 12 находок. Основная сеть ConvNeXt-T смотрит на каждый срез, и каждая находка «смотрит» только внутрь своей рамки: мениск — в мениск, связка — в связку. Во время обучения у сети две дополнительные задачи: угадать рамки поражений и угадать смысл заключения радиолога. На тесте их нет, но они учат сеть смотреть куда надо.
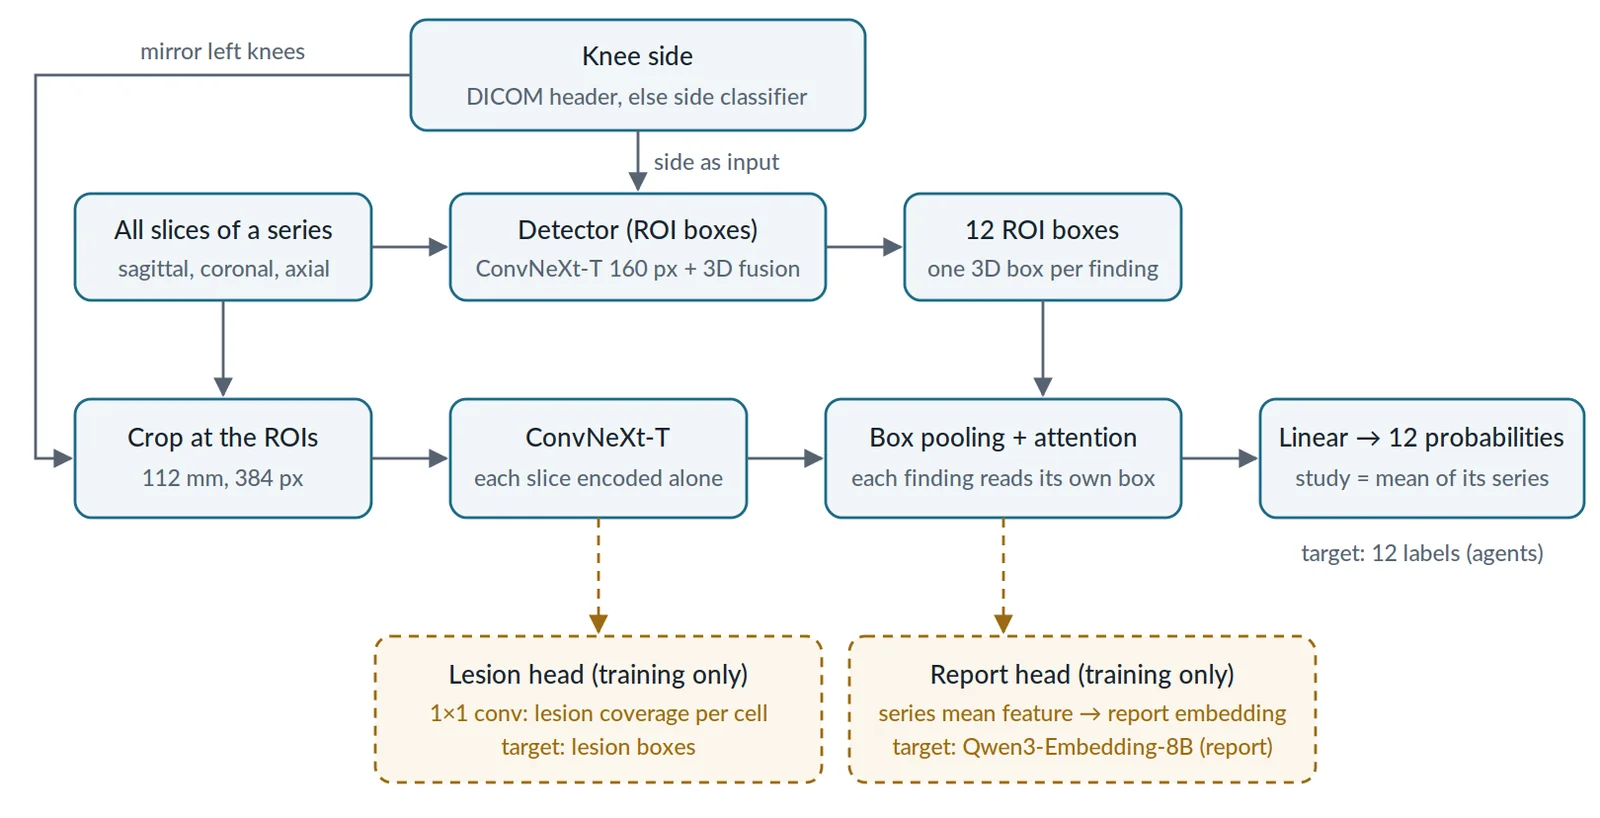
Я сам не до конца понимаю каждую деталь пайплайна, особенно как рамки используются в обучении. Чаще всего я просил Claude Opus 5.5 примерно так: «у нас есть такие разметки, предложи несколько подходов и запусти эксперименты» — и прирост шёл оттуда.
5-е, 7-е и 235-е места
5-е место (RB, Matheus, Tucker, Tony): Claude Opus 5.5 перечитала все заключения, GPT-6.1 смотрела по 10 срезов на выпот, синовит и кисту, а метки откалибровали по 58 эталонным. Отдельная модель сегментирует кости и вырезает четыре зоны: внутренний и наружный отделы, надколенник и межмыщелковую ямку — с разрешением до двух раз выше, чем на целом снимке.
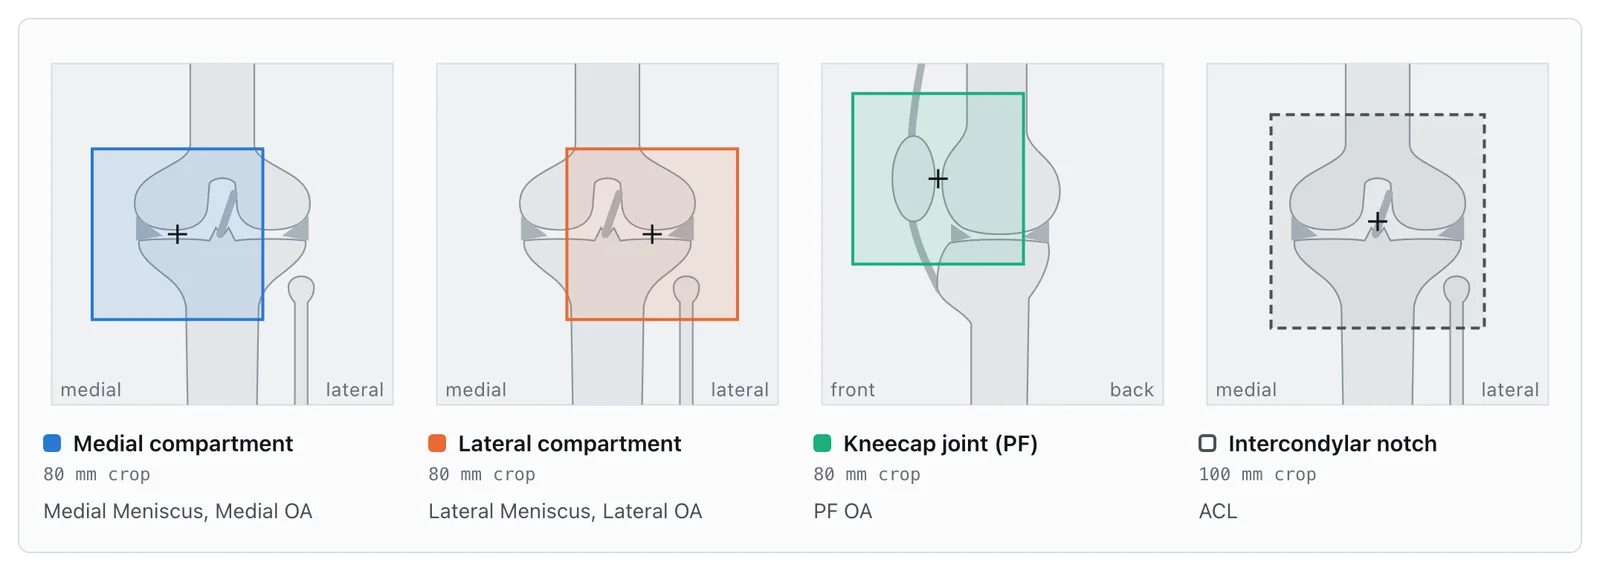
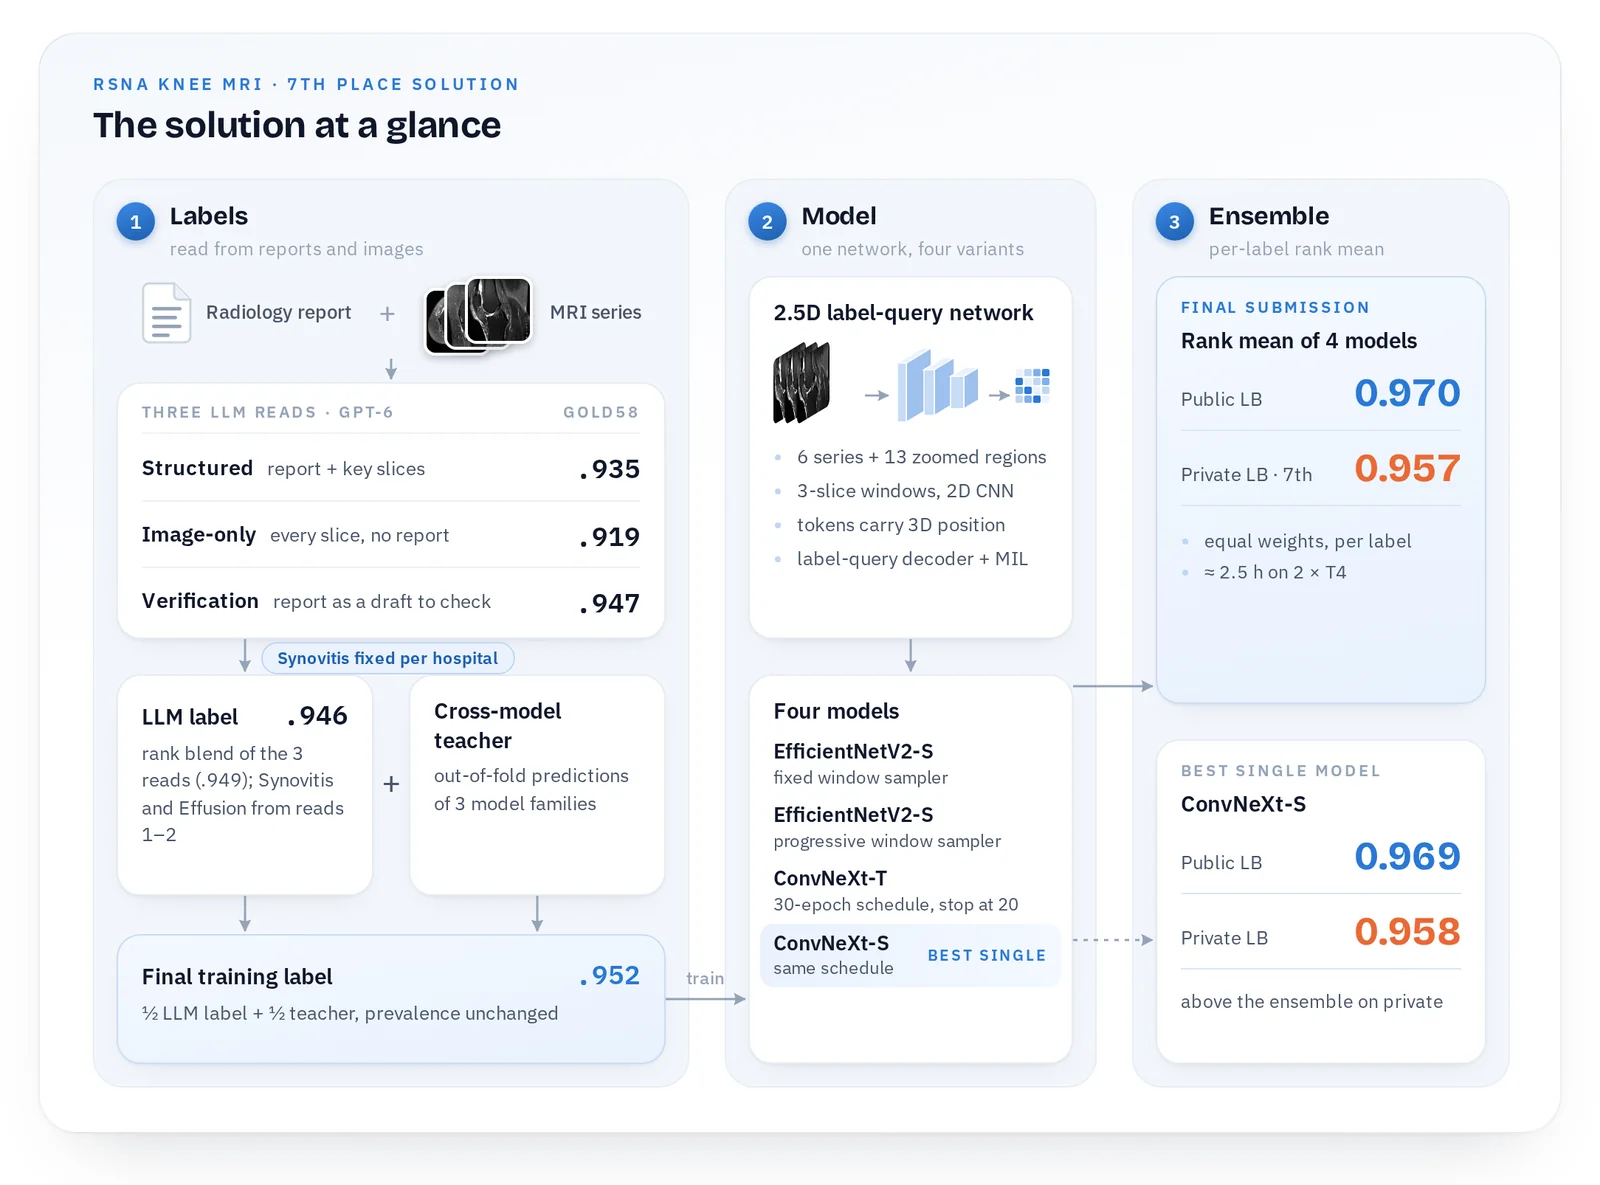
7-е место — Barry, №1 публичного лидерборда: одна архитектура 2.5D-сети в четырёх вариантах и никаких внешних данных, только данные соревнования. Весь прирост — от меток: GPT-6 читала заключение вместе со снимками тремя разными промптами, включая «заключение — черновик, проверь каждую находку по снимкам». А 235-е место (серебро) — команда грандмастера Криса Деотта, где ИИ-агент Gemini был полноценным участником команды и сам написал разбор от первого лица. Их лучший результат — смесь своей модели с публичным ноутбуком heliosli, того же автора, на чьём ноутбуке стоит и моё решение.
| Место | Откуда метки | Модель | Скор |
|---|---|---|---|
| 1 · Team Kangaroo | ИИ-агенты смотрят снимки и заключение, рисуют рамки | ConvNeXt-T + пулинг по рамкам, ансамбль | 0,960 |
| 5 · RB, Matheus, Tucker, Tony | Claude читает заключения, GPT смотрит срезы, калибровка | EfficientNetV2 + ConvNeXt, зоны по костям | 0,958 |
| 7 · Barry | GPT-6: заключение + снимки, три промпта | Одна 2.5D-архитектура × 4, без внешних данных | 0,957 |
| 235 · Chris Deotte + Gemini | Gemini, GPT, Claude по мозаике из 32 срезов | CoAtNet + смесь с публичным ноутбуком | серебро |
| 438 · я | Готовые открытые таблицы меток | Raptor + R7, смешивание по местам | 0,943 |

Что я из этого вынес
Для меня главное открытие — роль ИИ-агентов. Ещё пару лет назад разметить 4 000 МРТ мог только живой радиолог за месяцы. В этом соревновании агенты Codex и Claude тратили по 2,5 минуты на исследование и справились достаточно хорошо, чтобы обучить модель уровня 0,96 AUC. Победитель честно пишет, что многое в пайплайне придумал не сам, а попросил Claude предложить и проверить подходы. Это новая норма работы в Data Science.
Для Казахстана это тоже про нас. Хороших скелетно-мышечных радиологов мало и в Алматы, а в районах их нет почти совсем. Модель, которая на МРТ подсвечивает «здесь похоже на разрыв мениска, посмотри срезы 14–17», — это не замена врачу, а второе мнение и экономия времени. И, как показало это соревнование, собрать такую модель сегодня может небольшая команда с открытым кодом и ИИ-агентами.
Медаль на Kaggle сегодня берут не тем, что придумал самую умную сеть, а тем, что лучше всех разметил данные и ничего не сломал по дороге.
Код и ссылки
Мой ноутбук с описанием и ссылками на все использованные датасеты выложил в репозиторий github.com/mkhamzanov/competitions. Там же README со схемой конвейера и благодарностями авторам.
- Мой ноутбук на Kaggle — rsna-b1-ctrl
- Базовый публичный ноутбук heliosli (≈0,957 на публичном)
- Рецепт и веса Raptor — dreaddevelopment
- Веса Raptor с SWA — nartaa
- Бандл R7 (ConvNeXt-small × 4) — heliosli
- Офлайн-декодеры JPEG — goodpjw2008
- Разбор 1-го места — Team Kangaroo
- Метки ИИ-агентов 1-го места (открытый датасет)
- Мой сертификат на Kaggle
Спасибо RSNA, радиологам-разметчикам и всем, кто делился кодом на форуме. Без открытых ноутбуков этой медали бы не было — и я считаю, что это нормально, если честно об этом говорить.